Respuesta rápida
¿Qué son los embeddings?
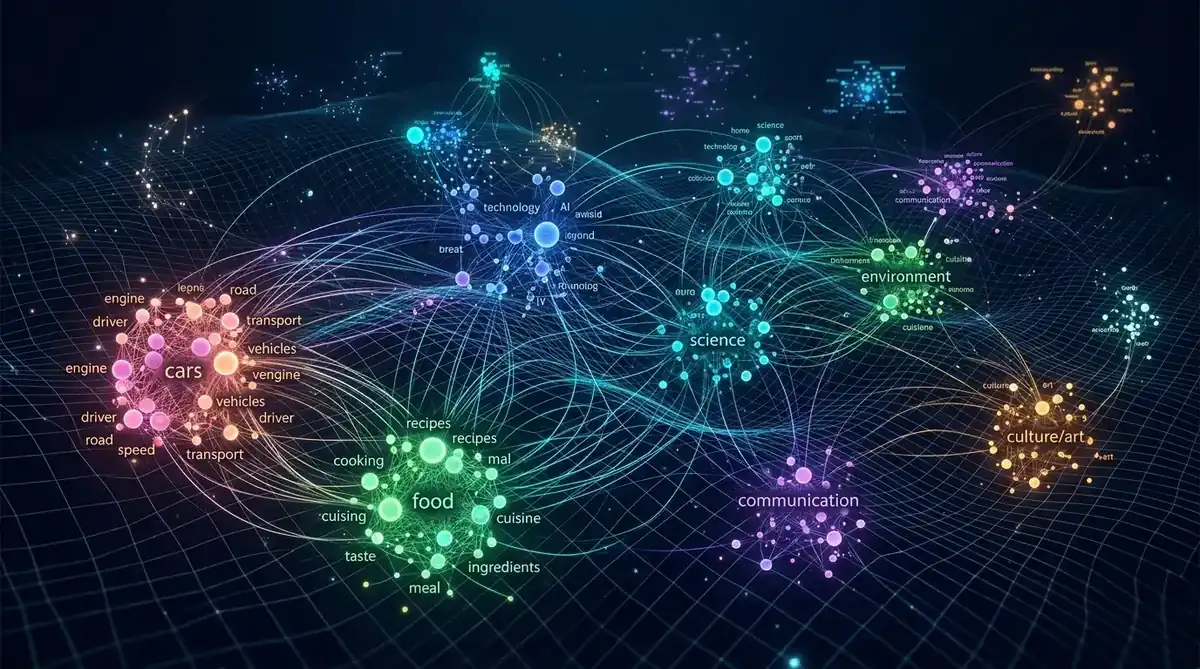
Un embedding es la posición de un texto, imagen o audio en un mapa de significado con cientos o miles de dimensiones: dos contenidos con sentido parecido quedan cerca en ese mapa aunque usen palabras distintas. Es la pieza que hace posible la búsqueda semántica, el RAG, la recomendación de productos y la clasificación automática. Generarlos es barato (desde 0,02€ por millón de tokens con OpenAI); el coste real está en almacenarlos en una base de datos vectorial.
Qué es un embedding (la analogía del mapa de ciudades)
Imagina un mapa donde cada ciudad ocupa una posición concreta según sus características. París, Barcelona y Roma están cerca porque son capitales europeas históricas con turismo cultural. Tokio y Seúl están cerca porque son capitales asiáticas tecnológicas. Marrakech y El Cairo están cerca porque son capitales norteafricanas con historia milenaria.
La distancia entre dos ciudades en ese mapa NO es geográfica — es de similitud. Aunque París y Tokio estén separadas físicamente por miles de kilómetros, su distancia en este mapa de "tipo de ciudad" depende de cuánto se parecen como destinos turísticos.
Un embedding es exactamente eso: la posición de un texto, imagen o audio en un mapa de significado. Dos cosas con significado parecido están cerca en ese mapa, aunque las palabras concretas que usen sean distintas.
La diferencia con un mapa real: en lugar de 2 dimensiones (latitud y longitud), un embedding moderno tiene cientos o miles de dimensiones, cada una capturando un aspecto del significado. Esto permite distinguir matices muy finos: una receta vegana para diabéticos está cerca de otra receta vegana para diabéticos, pero un poco más lejos de una receta vegetariana para diabéticos, y mucho más lejos de una receta tradicional con azúcar.
Lo importante: tú no necesitas ver ese mapa de cientos de dimensiones. Solo necesitas saber que existe y que la IA puede medir distancias en él. Esa medida de distancia es lo que permite búsqueda semántica, RAG, recomendación y muchas otras cosas.
Qué cosas permite hacer un embedding (sin entrar en código)
1. Búsqueda semántica (busca por significado, no por palabras)
El usuario busca "el coche no arranca" y el sistema encuentra artículos que dicen "problemas para encender el motor" o "falla la batería del vehículo". Las palabras son distintas pero el significado es el mismo — las dos frases están cerca en el mapa de embeddings. Esto es lo que hace que un buscador moderno funcione bien aunque el usuario no use las palabras exactas que tienes en tu contenido.
2. RAG (responder con tu información)
Cuando un sistema RAG recibe una pregunta, convierte la pregunta a embedding, busca los párrafos de tus documentos cuyo embedding está más cerca, y se los pasa al LLM como contexto. Sin embeddings, esto sería imposible: no podrías encontrar el párrafo correcto si el usuario usa palabras distintas a las del documento.
3. Recomendación (productos similares, contenido relacionado)
"Productos similares a este" en una tienda online. "Artículos relacionados" en un blog. Todos usan embeddings: cada producto/artículo tiene su posición en el mapa, y el sistema encuentra los que están más cerca del que el usuario está viendo. Cuanto mejores los embeddings, mejores las recomendaciones.
4. Clasificación automática
Clasificar emails entrantes, etiquetar tickets de soporte, asignar reseñas a categorías. Comparas el embedding del nuevo texto con embeddings de ejemplos de cada categoría — la categoría más cercana gana. Esta técnica es la base del sentiment analysis con IA en muchos casos prácticos.
5. Detección de duplicados (textos que dicen lo mismo con palabras distintas)
Si tienes 5.000 reseñas y quieres detectar las que dicen esencialmente lo mismo (para no responder 50 veces lo mismo), comparar embeddings detecta similitudes que la búsqueda por palabras nunca encontraría.
6. Búsqueda multimodal (texto que busca imágenes, imagen que busca texto)
Modelos modernos generan embeddings que viven en el mismo mapa para texto, imagen, audio y vídeo. Esto permite buscar imágenes con descripción textual, o buscar texto que describa una imagen. Es lo que hace funcionar "buscar por imagen" en Google Lens o Pinterest.
Embeddings vs búsqueda por palabras clave
| Búsqueda palabras clave (clásica) | Búsqueda con embeddings (semántica) | |
|---|---|---|
| Cómo busca | Coincidencia textual exacta o parcial | Por significado, no por palabras |
| Sinónimos | Necesitas configurarlos manualmente | Los detecta automáticamente |
| Errores tipográficos | Ignorados (no encuentra) | Tolerados (entiende intención) |
| Idiomas | Un idioma a la vez | Cross-lingual con modelos multilingües |
| Velocidad | Muy rápida | Más lenta (pero milisegundos) |
| Coste | Casi nulo | Bajo pero no cero |
| Cuándo usar | Búsqueda exacta (códigos, IDs, números de pieza) | Búsqueda en lenguaje natural |
La regla práctica: combina las dos. Búsqueda híbrida (BM25 para palabras + embeddings para semántica) suele dar mejores resultados que cualquiera de las dos por separado. Es lo que aplican Google, Bing y la mayoría de buscadores modernos por dentro.
5 casos PYME donde los embeddings cambian el resultado
Caso 1: ecommerce que mejora el buscador interno
Tienda online con 3.000 productos artesanales. Cliente busca "jersey rojo invierno mujer". Sin embeddings: busca solo productos con esas palabras exactas en título o tags. Pierde productos etiquetados como "sweater bordado granate temporada fría señora". Con embeddings: encuentra ambos porque son semánticamente cercanos. Aumento típico de productos relevantes mostrados: 40-80%, con conversión que suele subir 8-15%.
Caso 2: gestoría con biblioteca de circulares
Asociado consulta "qué hacer si un trabajador autónomo factura por encima del módulo y no lo declara". Sin embeddings, búsqueda devuelve solo circulares con esas palabras exactas. Con embeddings, encuentra la circular sobre "superación de límites en estimación objetiva y consecuencias fiscales" que es exactamente lo que el usuario busca aunque las palabras sean distintas.
Caso 3: hotel que clasifica reseñas multilenguaje
Reseñas en 7 idiomas distintos. Sin embeddings, clasificación requeriría diccionarios por idioma. Con embeddings multilingües, cada reseña va a su categoría (limpieza, servicio, ubicación, comida) sin importar el idioma — el modelo entiende que "clean room", "chambre propre" y "Zimmer sauber" caen en la misma categoría.
Caso 4: comercio que detecta duplicados en producto
Catálogo importado de varios proveedores con descripciones distintas para el mismo producto físico. Sin embeddings, identificar duplicados era manual. Con embeddings, detección automática del 85-95% de duplicados textualmente distintos pero semánticamente iguales. Limpieza de catálogo en horas, no semanas.
Caso 5: hostelería con FAQ inteligente para clientes
Hotel con FAQ extensa. Cliente pregunta "can I check in early?". Sin embeddings, FAQ podría estar etiquetada como "horario de entrada y check-in" en español y no encontrarse. Con embeddings multilingües, encuentra la respuesta correcta en el idioma original y la traduce/adapta. Es la base técnica de chatbots multi-idioma que funcionan bien.
Quién genera embeddings (los proveedores principales en 2026)
| Proveedor | Modelo | Coste 1M tokens | Dimensiones | Multilingüe |
|---|---|---|---|---|
| OpenAI | text-embedding-3-small | ~0,02 € | 1.536 | Sí, decente |
| OpenAI | text-embedding-3-large | ~0,13 € | 3.072 | Sí, bueno |
| Voyage AI | voyage-3 | ~0,06 € | 1.024 | Sí, muy bueno |
| Cohere | embed-multilingual-v3 | ~0,10 € | 1.024 | Sí, muy bueno (>100 idiomas) |
| Open-source (BGE, E5) | bge-m3, e5-large | 0 € (autohospedaje) | 1.024 | Sí |
Para PYMEs en España, las opciones óptimas son:
- OpenAI text-embedding-3-small: el más barato, funciona bien en español y catalán. Empezar siempre aquí.
- Voyage AI voyage-3 o Cohere embed-multilingual-v3: cuando necesitas calidad muy alta o trabajas con muchos idiomas.
- Open-source (BGE, E5): solo si volumen muy alto y privacidad crítica. Inversión en infraestructura justificable a partir de millones de tokens/mes.
Para casos de uso típicos de PYME (catálogo de productos, FAQs internas, reseñas), la opción de OpenAI cubre el 90% de las necesidades a precio testimonial.
Errores comunes al implementar embeddings
- Cambiar de modelo de embeddings sin re-indexar todo: cada modelo tiene su propio mapa. Los embeddings de OpenAI no son comparables con los de Cohere — viven en mapas distintos. Si cambias de modelo, debes re-indexar todos tus documentos. Mezclar embeddings de modelos distintos da resultados aleatorios.
- Olvidar que la similitud no es el único factor: dos textos pueden ser semánticamente cercanos pero no relevantes para el caso (ej: en una búsqueda de productos, un cliente que busca "vino tinto Rioja" probablemente NO quiere ver vino blanco aunque sea de Rioja). Combinar embeddings con filtros (categoría, atributos) mejora drásticamente la relevancia.
- Trocear los textos demasiado pequeños o demasiado grandes: para indexar documentos largos, hay que trocearlos. Trozos de 1.500+ tokens diluyen el significado, trozos de menos de 100 tokens pierden contexto. Tamaño óptimo: 200-600 tokens con overlap. Esto importa especialmente en RAG.
- Ignorar el coste de la base de datos vectorial: los embeddings son baratos de generar pero hay que guardarlos en algún sitio. Pinecone, Weaviate, Qdrant tienen coste mensual no trivial cuando el volumen sube. Para volúmenes pequeños, sqlite-vss o pgvector (extensión Postgres) son alternativas casi gratuitas.
- Usar embeddings cuando palabras clave son suficientes: para búsqueda de IDs, códigos, números de pieza, fechas, nombres propios — la búsqueda exacta es siempre mejor. No todo necesita semántica. Combinar palabras clave para campos exactos + embeddings para descripción libre es la receta robusta.
- No medir la calidad del retrieval: lanzar un sistema de búsqueda semántica sin un benchmark de 30-50 preguntas con resultado esperado. Sin medición, no puedes saber si el sistema funciona o no. Esto es exactamente el mismo principio de la auditoría con baseline cuantificada.
Errores que cometí yo mismo con embeddings
- Asumí que embeddings + similitud era suficiente sin filtros. En un primer proyecto de búsqueda de productos, la similitud semántica devolvía a veces productos descontinuados o sin stock. Solución obvia retroactivamente: filtrar por disponibilidad=true ANTES de calcular similitud, no después. La obviedad solo es obvia después de pisar el rastrillo.
- Usé embeddings monolingües para un sitio multilingüe. text-embedding-ada-002 (versión vieja de OpenAI) tenía calidad baja en catalán. Las búsquedas en catalán devolvían resultados aleatorios. Migré a text-embedding-3-small y la calidad subió drásticamente. Lección: en sitios multi-idioma, validar la calidad del modelo en cada idioma antes de comprometerse.
- No re-indexé al cambiar el tamaño de chunk. Cambié el chunk size de 512 a 300 tokens pero solo re-indexé los documentos nuevos. Resultado: la base tenía dos tipos de embeddings con tamaños distintos, las búsquedas se volvieron inconsistentes. Cuando cambias parámetros del pipeline de embedding, re-indexar TODO es obligatorio.
Conclusión: embeddings son la pieza invisible que hace funcionar todo lo demás
Los embeddings no son sexy. Nadie escribe en LinkedIn "implementé embeddings en mi empresa". Pero son la pieza técnica que hace funcionar prácticamente todo lo interesante en IA aplicada de 2026: RAG, búsqueda semántica, recomendación, clasificación automática, multimodal. Sin embeddings, todas esas técnicas serían imposibles o caras de implementar.
Para una PYME en 2026, no necesitas dominar la matemática detrás de los embeddings. Necesitas saber:
- Qué son (mapa de significado).
- Qué permiten hacer (los 6 casos del listado).
- Cuánto cuestan (muy barato generar, atención al coste de almacenarlos).
- Cuándo no usarlos (cuando palabras clave son suficientes).
- Y cómo los usa cualquier proyecto IA serio que toque información textual real.
Para entender cómo encajan en arquitecturas reales, mira el post de RAG para PYMEs —y, si ya vas a implementarlo, la guía de RAG empresarial con precios y fases— y la diferencia LLM vs agente vs workflow. Los embeddings están dentro de los tres.
¿Tu sistema de búsqueda interno se queda corto?
Diagnóstico gratuito: identifico si búsqueda semántica con embeddings encaja en tu caso, te explico arquitectura concreta y entrego cálculo de coste recurrente para tu volumen real.
Solicitar diagnóstico gratuitoO escríbeme a hola@cristiancorrales.com
Preguntas frecuentes sobre embeddings
Un embedding es la traducción de un texto, imagen o audio a una serie de números que captura su significado, no sus palabras exactas. Esa traducción permite a la IA comparar dos cosas por su sentido y es la base técnica de la búsqueda semántica, los sistemas de recomendación y RAG.
Internamente, ChatGPT convierte tu pregunta a embeddings antes de procesarla. Eso le permite entender que cuando escribes 'mi gato no come' y luego 'el animal rechaza la comida' estás hablando del mismo problema. Es lo que separa la IA moderna de las búsquedas por palabras clave del 2010.
Las palabras clave buscan coincidencia textual exacta. Los embeddings buscan por significado: 'coche', 'automóvil' o 'vehículo' devuelven resultados similares porque su embedding es parecido. La búsqueda por palabras clave es rápida y exacta; con embeddings es más cara pero entiende lo que quieres decir.
No. Para usarlos en una PYME basta entender el concepto: texto entra, números salen, dos textos similares dan números parecidos. Las APIs de OpenAI, Anthropic, Voyage o Cohere los generan en una sola llamada.
Muy barato. OpenAI text-embedding-3-small: ~0,00002€ por 1.000 tokens. Para indexar 5.000 productos con descripción de 500 palabras: ~2-5€ total una vez. Re-indexar cuando cambia: ~0,50-2€/mes. La parte cara no son los embeddings — es la base de datos vectorial.
¿Te planteas usar IA en tu negocio?
Implemento chatbots y agentes de IA para pymes del Camp de Tarragona: casos concretos, con retorno medible, desde 1.200€.
Cuéntame tu caso →¿Prefieres números antes de hablar? Calcula el ROI de tu proyecto de IA en 2 minutos →
¿Quieres ver casos reales de IA en pymes?
Te escribo solo cuando tengo un caso con costes y resultados reales, o una herramienta que merece la pena. Sin humo, sin spam y baja en un clic.